- +1
等AI回答?以后不用了——OpenAI把旗舰模型加速14倍,每秒750个词意味着什么
你大概有过这样的体验:给AI发一个问题,然后盯着屏幕等它一个字一个字地往外蹦。快的时候几秒出结果,慢的时候能等上一两分钟。如果涉及复杂推理,你甚至可以去倒杯咖啡再回来看。
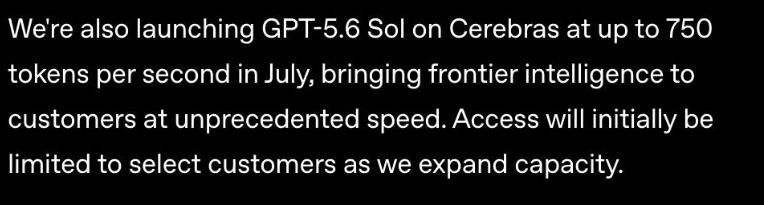
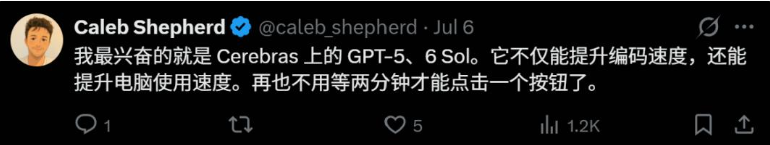
8月份,OpenAI给出了一个新的数字:750。不是750毫秒,是每秒750个Token。换算成中文,大约每秒输出上千字。一个问题的回答,可能比你读完它的时间还短。
这个数字来自OpenAI和Cerebras联合推出的"超高速模式"(Ultrafast Mode),把旗舰模型GPT-5.6 Sol的推理速度提升了最高14倍,同时不降低任何质量。目前面向少量客户开放有限预览。
一、速度和智能,终于不用二选一了
AI推理领域一直有个不成文的规矩:想要快,就得用小模型。大模型聪明但慢,小模型快但笨。OpenAI自己的产品线也是这么分的——Sol是旗舰,Luna和Terra是更轻量、更快的版本。用户需要根据场景在"聪明"和"快"之间做取舍。
Ultrafast模式打破了这个取舍。GPT-5.6 Sol是OpenAI目前最智能的模型,在法律文书、金融建模和工程报告等高难度任务上表现最佳。Ultrafast让它在保持满血智能的同时,跑出了小模型都达不到的速度。
具体多快?Standard模式下GPT-5.6 Sol的输出速度约53 tokens/秒。Ultrafast模式最高750 tokens/秒,14倍。横向比较,比Anthropic的Fable 5快11倍,比Opus 4.8的Fast模式快5倍。
这些数字不只是"感觉更快"。Cerebras做了一组实测:在"人类终极考试"(HLE)——一项包含2500道博士级难题的基准测试上,GPT-5.6 Sol Ultrafast模式用11小时11分钟答完全部题目。作为对比,Claude Fable 5花了78小时27分钟,超过三天的连续计算。准确率相近,速度快了近7倍。
二、瓶颈不在算力,在搬数据
要理解为什么能快这么多,得先理解传统GPU为什么慢。
大模型生成文本是一个逐Token的自回归过程。每生成一个词,GPU都需要把整个模型的权重从显存(HBM)搬到计算核心,算完再搬回去,生成下一个词时再搬一次。模型越大,权重越多,搬运的开销就越大。这个开销不是计算能力的瓶颈,是数据搬运的瓶颈——业内叫"内存带宽墙"。
英伟达的H100芯片有800亿个晶体管,其中用于计算的算力其实并不弱。但片上SRAM容量有限,装不下动辄数千亿参数的大模型,只能把权重放在片外HBM里,通过NVLink互联。搬运的距离虽短,但架不住每生成一个Token就要搬一轮,累积起来就成了瓶颈。
Cerebras的思路完全不同。它不造传统大小的芯片,而是把整片晶圆做成一颗芯片。最新的WSE-3,4万亿个晶体管——是H100的50倍。90万个AI核心,125 petaflops算力。关键是片上集成了44GB的SRAM,模型权重直接常驻在芯片内部,不用来回搬。
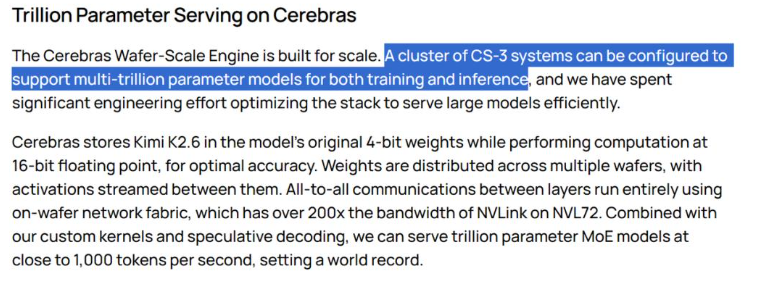
当然,GPT-5.6 Sol的完整参数量远超44GB。Cerebras的方案是"多晶圆流水线并行":把模型的不同层分布到多颗晶圆上,每层参数常驻在各自芯片的SRAM中,Token在晶圆之间像流水线一样传递。这就避开了传统多GPU方案中跨芯片通信的延迟问题。
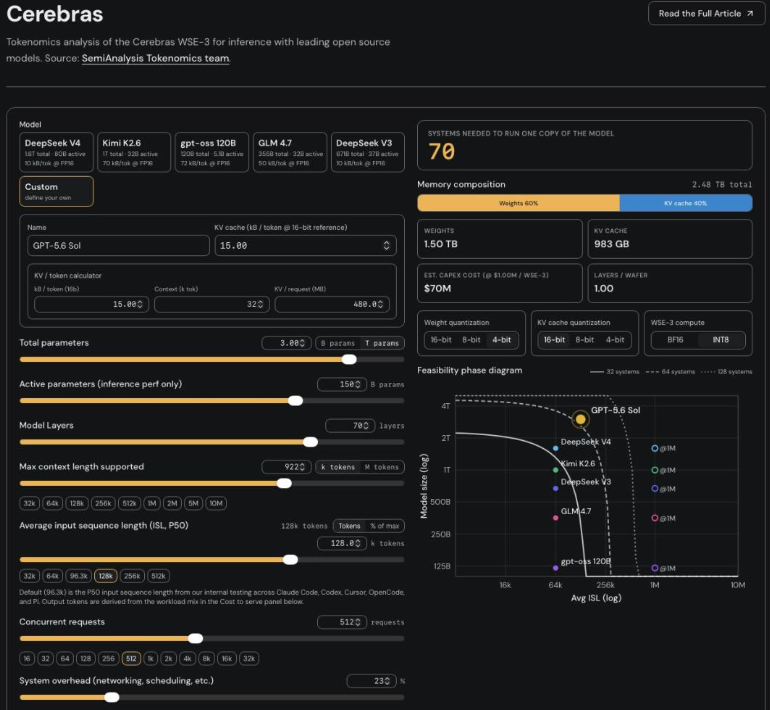
本质上是把"反复搬数据"变成了"数据不动,Token流动"。这是架构层面的差异,不是工艺层面的优化。
三、14倍速到底改变了什么
速度快14倍,不只是"少等一会儿"那么简单。它改变的是AI能用在什么地方。
OpenAI在公告里列举了几个场景。系统故障时,AI可以在宕机还在发生的同时分析日志、定位原因、准备修复方案。金融交易中,AI可以实时分析市场信号、评估交易、识别异常活动。客服电话里,AI可以即时处理复杂问题,不需要让客户等在线。购物场景下,AI可以在用户犹豫的时候就完成商品推荐和库存检查。
这些场景有一个共同特征:时间窗口很短,错过了就没用了。之前用Standard模式,AI可能需要几十秒甚至几分钟才能给出一个高质量回答,在这些场景里派不上用场。Ultrafast把响应时间压到秒级,AI就从"后台批量处理工具"变成了"前端实时交互系统"。
对Agent工作流的影响更大。一个复杂的Agent任务可能需要多轮工具调用、代码生成、错误修正和链式推理。每一步都要等模型响应,串起来可能要几个小时。速度快14倍,几小时的流程压缩到几十分钟,甚至几分钟。OpenAI内部已经在用Ultrafast做事故响应和研究实验——以前需要跑一夜的实验,现在工作日内可以迭代多轮。
早期客户反馈也印证了这一点。Jane Street的工程师说速度提升让他可以更专注地和模型协作;Podium说在语音客服场景中,速度"彻底改变了通话体验";Rogo的判断更直接:速度不只让产品体验更好,它改变了人们能用AI做什么。
四、快是真的快,但问题也有
Ultrafast模式目前有几个现实限制。
第一,产能。Cerebras是一家2015年成立的芯片公司,和英伟达的体量不在一个级别。WSE-3的晶圆级芯片制造难度极高,良率和产能都是现实问题。OpenAI目前只开放了"有限预览"给少量客户,明确说"随着产能增长逐步扩展"。社区里已经有人在问:Luna和Terra版本什么时候也能上Ultrafast?答案是——得看Cerebras的芯片够不够用。
第二,价格未公布。OpenAI现有的服务层级里,Standard模式输入10美元、输出40美元每百万Token,Fast模式输入10美元、输出60美元。Ultrafast的价格还没有披露,但考虑到Cerebras芯片的稀缺性和专用性,大概率不会便宜。
第三,这目前只覆盖了一个模型。GPT-5.6 Sol是旗舰,但不是所有场景都需要旗舰。很多日常任务用Luna或Terra就够了,而那些模型暂时还没有Ultrafast版本。
尽管如此,这个信号的意义大于产品本身。过去两年,AI竞赛的主旋律是"谁的模型更聪明"——参数更大、跑分更高、能力更全。Ultrafast开辟了第二条战线:"谁的模型更快"。当智能水平接近时,速度就成了差异化的关键。Cerebras的晶圆级架构证明了一件事:推理速度的瓶颈不是物理极限,是架构选择。
更深一层,这预示着AI使用方式的转变。当模型能在秒级给出高质量回答,人和AI的交互模式会从"发指令、等结果"变成"实时对话、边聊边做"。AI不再是需要等待的工具,而是能跟上你思维速度的协作者。
750 tokens/秒。这个数字本身也许很快就会被超越。但它标记了一个转折点:AI竞赛不再只比谁更聪明,还要比谁更快。而在"快"这条路上,刚起跑。
本文为澎湃号作者或机构在澎湃新闻上传并发布,仅代表该作者或机构观点,不代表澎湃新闻的观点或立场,澎湃新闻仅提供信息发布平台。申请澎湃号请用电脑访问http://renzheng.thepaper.cn。

- 报料热线: 021-962866
- 报料邮箱: news@thepaper.cn
互联网新闻信息服务许可证:31120170006
增值电信业务经营许可证:沪B2-2017116
© 2014-2026 上海东方报业有限公司