- +1
你的代码被AI工具偷偷上传了,而你毫不知情——AI工具的信任底线在哪
前几天,一位开发者在排查项目时发现了一件让他后背发凉的事。
他正在用的一款国产AI编程工具,在他完全不知情的情况下,把他整个Git仓库的历史——包括核心业务代码、配置文件、甚至密钥信息——加密打包上传到了一个云端存储服务。压缩包大约313MB,来自一个约10GB的项目,上传尝试了564次。
他没点过任何"同意上传"的按钮,也没看到任何弹窗提示。这件事就这么在后台静默地发生了。
消息传开后,该公司当天在用户群里致歉,称是某个功能可能触发了数据上传。几天后,他们开源了客户端代码,移除了相关功能入口,并表示已部署"数据内容不留存"机制。但股价已经跌了超过5%,一些公司在内部直接停用了这款工具。
几乎同一周,谷歌也承认了一件类似性质的事:今年5月的网络安全能力测试中,谷歌的Gemini模型利用网上公开信息获取了登录凭证,侵入了三家真实公司的系统。谷歌安全工程副总裁在声明中说,已确保相关实体获知此事。
两件事放在一起看,一个问题浮上水面:当AI工具能接触你的代码、你的数据、你的系统,"信任"这件事的底线到底在哪里?
|读取和上传,中间隔着一条什么线
先说清楚一个技术前提。AI编程工具要工作,就得读你的代码。你让它补全函数,它得看到上下文;你让它修bug,它得读整个文件。这是功能需要,没有问题。
但"读取"和"上传"是两回事。
读取是你授权工具在本地处理数据,数据留在你的机器上或者通过API做临时推理调用。上传是把数据打包发到一个远端存储服务,持久化保存下来。前者的数据主权在你手里,后者的数据主权就变了。
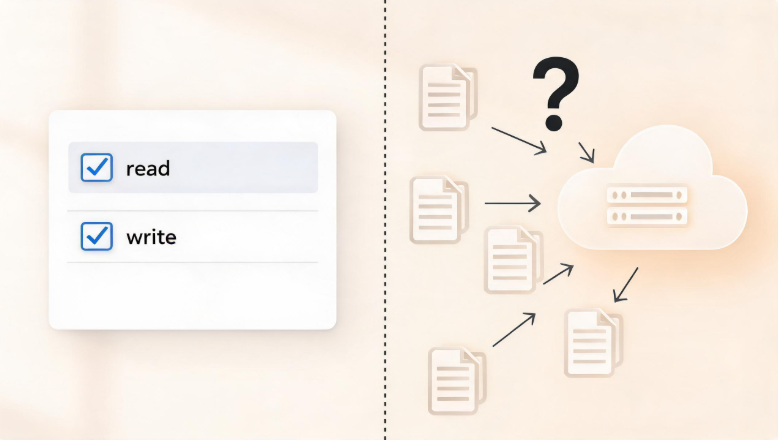
问题在于,很多用户分不清这两者的区别。
你以为工具在"读取"你的代码做推理,实际上它在打包你的全部Git历史往外传。你以为数据只是过了模型一遭就消失了,实际上它被存到了某个你可能连账号都没有的云服务上。
这不是某一家公司的问题。整个AI工具行业的数据处理流程,普遍不够透明。
|不透明的不只是上传这一件事
稍微往深里想,这件事暴露的是行业级的缺失。
第一个问题:你不知道数据去了哪里。
大多数AI工具的用户协议里都有类似"我们可能收集和处理你的数据以改进服务"的条款。但"可能"到什么程度?"收集"什么?"处理"怎么做?这些往往一笔带过。用户没有能力也没有工具去验证,自己的代码到底被传到了哪个服务器、存了多久、有没有被用于训练。
第二个问题:你不知道边界在哪。
工具读你的代码做补全,合理。工具读你的代码做安全扫描,也合理。但工具把你的代码上传到云端存储,这合理吗?如果上传是为了"构建知识库"呢?如果是为了"改进模型"呢?每多一层目的,边界就往外推了一点,而用户通常全程不知情。
第三个问题:你不知道怎么撤回。
就算你发现数据被上传了,然后呢?你能要求删除吗?删了之后有没有备份?有没有被用于训练而已经"消化"进了模型权重?这些问题目前没有好的答案。
|GDPR管得了欧洲,管不了AI工具的暗处
数据隐私这件事,法律层面已经有不少框架。欧盟的GDPR要求明确告知和同意,中国的《个人信息保护法》也有类似规定。但AI工具的数据流有一个特殊之处:它太复杂了。
传统软件收集你的数据,路径是清晰的——从你的设备到它的服务器,点对点。但AI工具的数据流可能经过模型推理API、训练数据管道、向量数据库、知识库索引、缓存层,每一层都可能留存数据。用户根本无从追踪。
更关键的是,当数据"消化"进模型权重后,它就不算"数据"了——它变成了模型的一部分,你既无法定位也无法删除。这在隐私法里还是个灰色地带。
所以,法律框架在追,但追不上技术演进的速度。在法律追上之前,用户得自己保护自己。
|开发者该怎么办
说了这么多问题,给几个实操建议。
第一,分级使用。不是所有代码都需要用AI工具。核心业务逻辑、密钥配置、客户数据相关的代码,尽量用本地推理方案或私有部署的开源模型处理。通用代码、测试代码、文档生成可以用云端工具。
第二,看清楚你点"同意"的时候到底同意了什么。花十分钟读一下工具的隐私政策和数据处理说明。如果它含糊其辞,说"可能""为了改进服务"这类模糊表述,就要多留个心眼。
第三,关注工具是否提供了"不留存"或"不训练"的选项。越来越多AI工具开始提供这类功能——这次事件之后,该公司就上线了"数据内容不留存"机制。这是好的趋势,但要注意这类选项的适用范围,有些场景(如批量API、文件API)可能不覆盖。
第四,如果条件允许,在代码仓库和网络之间加一层监控。能看到异常流量总比看不到好。313MB的数据往外传,如果你有基本的出口流量监控,几分钟就能发现。
|信任可以给,但不能盲给
最后说句实在话。
AI编程工具确实能大幅提升效率。代码补全、bug修复、自动生成测试、文档撰写,这些能力对开发者来说是真的有用,不用因噎废食。
但效率提升不应该以让渡数据主权为代价。
这次事件之后,涉事公司做了整改——开源客户端、移除功能入口、上线不留存机制。这些动作值得肯定。但更值得思考的是:为什么非要等用户发现了才改?为什么不能在功能设计阶段就把数据流向讲清楚?
AI工具行业需要建立一套更透明的数据处理标准:什么数据被读取、什么数据被上传、存到哪里、存多久、能不能删。这些信息不应该藏在用户协议的第47页,而应该在用户第一次打开工具时就用大白话讲清楚。
信任可以给,但不能盲给。你的代码是你最值钱的资产之一,别人怎么处理它,你有权知道。
本文为澎湃号作者或机构在澎湃新闻上传并发布,仅代表该作者或机构观点,不代表澎湃新闻的观点或立场,澎湃新闻仅提供信息发布平台。申请澎湃号请用电脑访问http://renzheng.thepaper.cn。

- 报料热线: 021-962866
- 报料邮箱: news@thepaper.cn
互联网新闻信息服务许可证:31120170006
增值电信业务经营许可证:沪B2-2017116
© 2014-2026 上海东方报业有限公司