- +1
《学会与AI共存》对话数学家丹尼尔·利特(Daniel Litt)——Numberphile播客by 布雷迪·哈兰(Brady Haran)
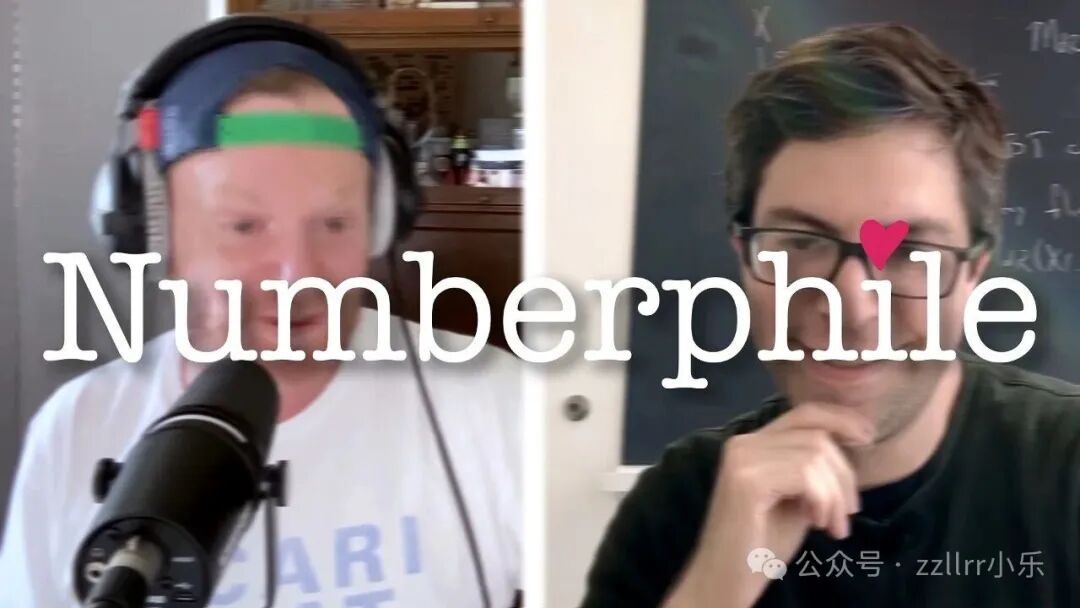
来源播客:Numberphile
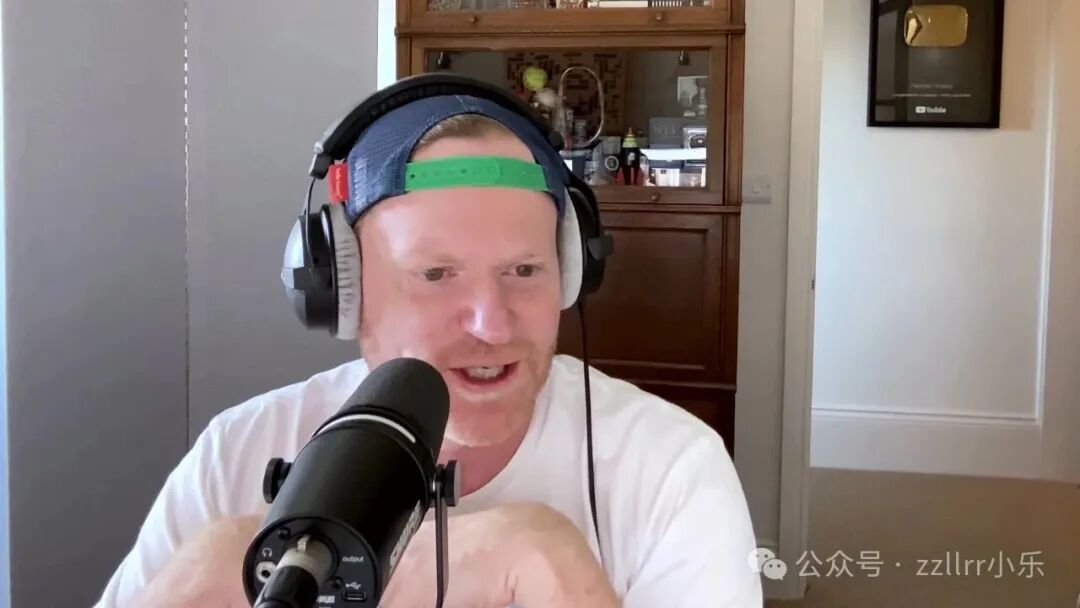
播客主:布雷迪·哈兰(Brady Haran)
今天我邀请到丹尼尔·利特(Daniel Litt),一位美国数学家(在加拿大任教)。在我看来,他属于对AI革命持乐观态度的那一派。他有不少很有意思的思考,我想在这里分享出来,供大家参考。
另请参阅:
专访丹尼尔·利特(Daniel Litt):数学家还剩下什么?——信息瓶颈播客2026-10-20
数学家心声:Daniel Litt丹尼尔·利特《数学的一个新开端》2026-9-14
数学家丹尼尔・利特(Daniel Litt)创建的数学未解难题网站正式上线——ProblemsILike.com
巴别图书馆中的数学——多伦多大学数学家丹尼尔・利特(Daniel Litt)再谈AI人工智能与数学研究的未来
专访数学家Daniel Litt(丹尼尔・利特):AI人工智能的数学能力或长期处于不均衡发展状态(上)
专访数学家Daniel Litt(丹尼尔・利特):AI人工智能的数学能力或长期处于不均衡发展状态(下)
我们的对话发生在OpenAI发布那份备受热议(也饱受争议)的纳维-斯托克斯证明之后,十月初那批大规模批量证明成果放出之前。这段时间差并不会改变丹尼尔核心观点,但我希望大家能了解完整背景。
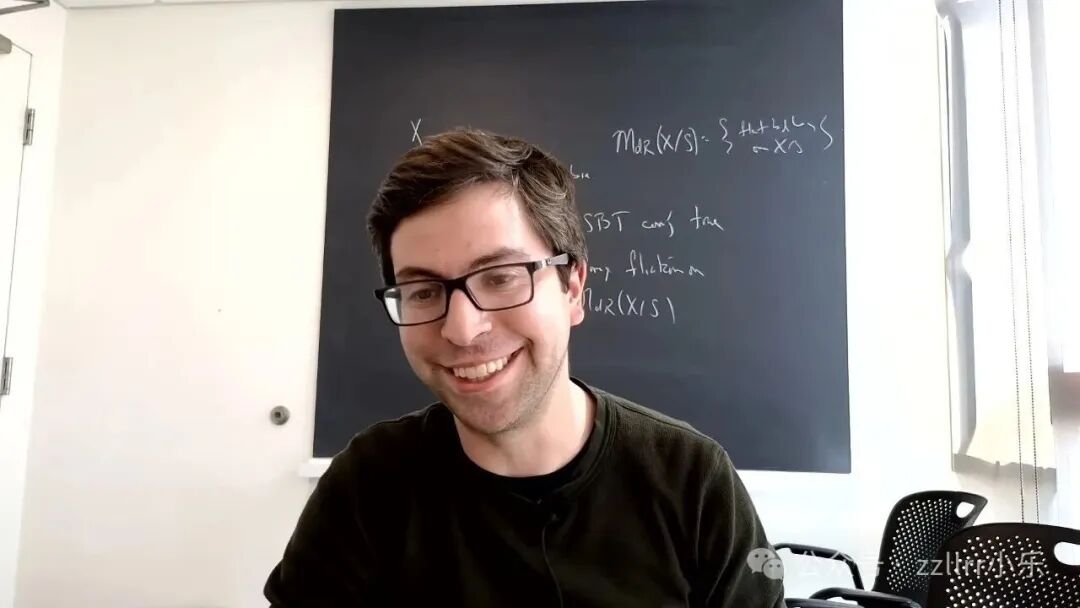
受访人:丹尼尔·利特(Daniel Litt)
丹尼尔·利特:我是一名数学教授,主要研究代数几何与数论。平时大多在多伦多大学任教,这学期我在哈佛访学。和大多数数学教授一样,我很多时候就只是放空发呆,思考问题。
大体来说,我的研究目标是搞清楚数和形之间有什么样的关联。落实到具体工作上,就是研究由多项式方程组的解集定义出来的几何图形,去理解这些几何性质,和方程组解的算术性质之间有什么联系。
主持人:你的研究是不是非常依赖图像化思考?你会经常在纸上画三角形、几何图形吗?还是说,等问题进入你的脑海时,就已经全部转化成数字和方程了?
丹尼尔:我确实是偏向图像化思考的人。
但我研究的对象大多是高维的,很难直接画出来。所以我常常画一些简化草图,可能看起来就像一块带几条线的椭圆形。这张草图里的某些特征,用来捕捉底层几何结构的某一部分。我很少能亲眼看到我研究的那些几何体,不过最近倒是有几次这样的机会。
主持人:那教学占你工作多大比重?你会花很多时间培养下一代研究者吗,还是你的工作重心更多是独立做研究?
丹尼尔:我很喜欢教书。
这学期我没有授课,但正常情况下我每年会带两到三门课。最近带的大多是高阶课程,面向高年级本科生或者研究生。指导学生算是我工作里最喜欢的部分之一。不过我上过的最满意的一门课,是给大一新生开的证明入门课。我授课量不小,而且真心喜欢教学。
主持人:你的研究里,多少时间是独自坐着发呆思考?多少时间是和合作者一起讨论、站在黑板前推演?你的研究日常是什么样的?
丹尼尔:这个问题很好。
我最近大概十篇论文都是和合作者一起完成的,我非常享受和别人一起研究数学。一般我们每周会面一两个小时,其余大部分时间,就是各自对着黑板、纸笔独自琢磨。我算是比较喜欢交流的数学家,和别人讨论数学,是我开展研究很重要的一环。
主持人:回顾你的学术生涯,那些重大突破、灵光一闪的时刻,那种“哇,我做出很棒的成果了”的瞬间,大多是独自思考时出现的,还是和别人讨论的时候?灵感火花一般在哪种场景迸发?
丹尼尔:大多是和别人交流的时候。
和别人聊数学,我更容易想通问题。典型情况是:我和合作者各自埋头研究一周,毫无进展;等到碰面的时候,互相讲清楚自己卡在哪一步。在解释的过程里,思路一下子就清晰了,原本卡住的壁垒就打通了。当然也有独自取得进展的时候。
我印象很深的一次:我发现自己论证里有一处漏洞,之后要开车一个半小时去别的地方。出发大概十五分钟的时候,我突然想到修补这个漏洞的办法,接下来一个小时十五分钟的车程我完全没有印象。现在回想起来,那次开车其实挺危险的,但抵达终点的时候,我已经想好怎么修正证明了。
主持人:你当时没有靠边停车记下来吗?不担心转头就忘掉?
丹尼尔:我基本就是自动驾驶式开车,脑子全在想证明。
数学圈里也有类似的有名轶事:芝加哥有位数学家载别人开车,会故意把挡风玻璃弄起雾,直接在上面演算。说到底,千万别和正在思考数学的数学家同车。不过这也是灵光乍现的一种方式。
主持人:你还有别的思考小窍门吗?举个例子,我自己很喜欢洗澡、泡泳池的时候思考,很容易冒出想法。你有没有偏爱用来思考的地点、散步或者静坐的习惯?
丹尼尔:当然有。如果完全卡住了,我最常用的办法是躺在沙发上闭眼。我不是睡觉,我在做数学,高强度思考。另外有时候我会打15–20分钟电子游戏,这个办法也很管用。
主持人:必须问一句,你现在常玩什么游戏?
丹尼尔:《杀戮尖塔2》,非常好玩,强烈推荐。我没有收到Metacritic的推广哈。
主持人:我没听过这个游戏。【笑声】
接下来我们聊聊AI。首先想问问你和AI打交道的历程。我想了解,AI刚慢慢进入数学领域的时候,你是什么状态?是抵触,还是慢慢接纳?在你的学术生涯里,你和AI的关系是怎么一步步变化的?
丹尼尔:我关注AI很久了,最早开始尝试是2022年,那时候GPT-3刚出来不久。当时能体验它的渠道是一款叫《AI Dungeon》的文字游戏,相当于DND桌游,GPT-3充当地下城主讲故事。我一般会扮演一名数学教授,试着让它做数学题,这是我当时能接触GPT-3的方式。
主持人:你不是为了推进研究,只是想看它处理数学的能力怎么样?
丹尼尔:对。
2022年的时候它准确率很差,就连两位数加法都经常算错,完全谈不上实用。之后GPT-3正式推出,我试着让它写证明,就是高中证明课那种基础命题,比如费马小定理。我持续试了很久。说实话,当时行业热度很高,很多宣传夸大了能力,和它真实水平不符。GPT-4可以运行代码,计算任务靠谱一点,但它的推理能力,远远达不到宣传里说的水平。
推理模型是2024年9月第一批上线的,从这时开始才算真正有点用处。它一般解不出有意思的开放难题,但可以用来学习一个领域、做文献检索。我第一次真正在研究里用上大模型,是去年2025年夏天这一代推理模型。我用它学习超凯勒流形相关知识,对我的研究很有帮助。
主持人:是用来学习已有知识,还是去攻克前沿难题?
丹尼尔:我当时在研究一类特定的超凯勒流形,这个方向我并不熟悉,只是略有了解。
除了课本、论文之外,我试着用AI辅助学习,体验挺有意思。但那时模型错误很多,经常90%内容正确,藏着一处漏洞,逼着我时刻保持警惕,仔细甄别错误。直到现在,文献检索、辅助学习,依然是我最主要的两种用法。
它像一个超强语义搜索引擎:我可以直接描述我的想法,问有没有相关研究。有时候它能帮我找到一些冷门方向的文献,那些领域用词和我熟悉的体系不一样,用谷歌检索很难搜到,这点特别好用。直到不久前,我很少直接让AI去证明一条引理。
当然,早在今年一月,公开模型就已经证明过一些有意思的猜想。但这更像是霰弹枪式打法:海量猜想里,它碰巧解决了极小一部分。单独拿一个问题去问,大概率指望不上。不过现在情况开始变了,现在我想证明一条引理,模型大多可以完成,甚至做得更多。
主持人:给外行解释一下,你随口说“证明一条引理”,听起来好像不是很难?引理是低阶的数学结论吗?
丹尼尔:我不是轻视模型能做到这件事。
像纳维-斯托克斯这种知名猜想,和引理不是一个量级。引理一般是为了证明更大结论,中途需要证明的小结论。更大的结论我们根据情况叫定理或者命题。当然现在模型也能证明定理。难度高低取决于研究领域、问题本身,还有研究者个人。
对我来说,很少出现这种情况:我知道一条定理或者引理的陈述,但完全不知道怎么证明它。这种情况当然有,但不多。我通常是先有一个不够严谨的想法,或者观察到某种现象,在理解这个现象的过程里,同步推导出定理陈述和对应的证明。
主持人:有没有已经发表或者正在撰写的论文,AI有一定贡献,帮你分担了一部分思考工作?
丹尼尔:正好有一篇已经发表的,还有一篇在写,算是很有意思的案例。
四月份我发了一篇论文,里面两条引理的论证分别由Gemini DeepThink和谷歌DeepMind的内部模型Aletheia完成,Aletheia是Tony Feng搭建的框架。
故事很有意思:这篇论文的主定理,我们在前一年12月就证完了,那时候AI还没法有效处理代数几何问题。我和合作者只是对中间几条引理的表述不满意。就像建好一栋房子,发现里面几根承重的墙体有点不稳,想要加固。不是担心正确性,只是觉得表述不够理想。
举个例子:我们有一个很难实际计算的大型矩阵,我们确定它存在,想求它的行列式、秩。我们只知道秩至少是50,想确认它是不是刚好等于50。我们本来只需要“秩≥50”这个结论,但如果能确定精确值当然更好。
当时顶尖模型没法直接给出答案。我们自己算了很多例子,找到了一个更好的猜想式解释,说明为什么秩恰好是50。有了这个优化后的表述之后,Gemini DeepThink直接证明了这个解释成立。
主持人:也就是说,不只是单纯靠算力,你也借助了它的推理能力?
丹尼尔:没错。
这里有个很值得琢磨的点:现在你直接让顶尖模型去证明“这个矩阵秩等于50”,GPT6也能做到,会输出一份长达十页、繁琐枯燥的计算证明。但它不会找到我们提炼出来的那个更优美的解释,我也不知道怎么引导它产出这种洞见。这里面就丢失了一些东西。
说实话,我本来就知道这种十页长的蛮力论证在理论上可行,只是我自己实在不想花精力去算。有AI代劳当然很好,但如果我们只是直接丢给GPT6,收下这份冗长证明,我们就没法这么深刻地理解这个问题。
当然,我们拿到证明之后依然可以选择拒绝这种粗糙版本,去寻找更有解释力的思路。但模型能力变强之后,我们必须更有意识地去追求真正的理解。这是第一个例子。
第二个例子是我和乔希·兰姆正在合作的项目,研究增长曲率峰值猜想。研究过程里冒出一个问题,涉及我并不熟悉的理论:格罗莫夫和肖恩提出的、从黎曼流形到仿射建筑的调和映射理论,偏向分析方向,不是我平时深耕的领域。我一边自学这套理论,一边出于好奇把问题丢给模型。
它给出了一个很漂亮的部分结论,还把这个问题和我不了解的辛几何方向联系起来,特别有意思。它只给出了局部答案,还有大量工作留给我。但这极大地激发了我的动力,主动去学习这个我一直感兴趣的领域。对我来说,AI是打开了一扇门,而不是关上一扇门。
主持人:最早你甚至在游戏里找渠道体验AI,一方面是天性好奇,另一方面,你当时是不是隐约预见到之后的发展?
丹尼尔:完全没有预判,纯粹是好奇。
如果2022年你问我,20年后AI会发展到什么程度,我只能说或许会做出一些很厉害的成果。2025年3月我还打过一个赌:到2030年之前,模型不会产出高质量、可落地的数学成果。显然,我猜错了。我严重低估了它的进步速度。
主持人:我今天刚听了你五个月前的一期播客,当时你说这些能力可能还要等十到十五年才会实现,结果现在AI已经做到了。
丹尼尔:应该是去年12月Epoch那期访谈。那时候它确实还没做出什么亮眼成果,发展速度实在疯狂。我以前习惯保守预估,说“大概十五年之后”,但确实低估了迭代节奏。
主持人:如果和不懂数学的朋友喝咖啡闲聊,对方说:“我听说AI一下子在数学领域做出好多惊人成果”,你会怎么跟他解释当下的真实局面,尤其是近几个月的变化?
丹尼尔:我会这么说:
现在AI非常擅长一类数学任务——给定一个精确写好的命题,尝试证明它。
当然就算命题本身是对的,它也未必总能成功,哪怕证明思路不算复杂。
大体上,如果这个结论可以用标准方法证明,尤其是我本人已经知道怎么证,模型大概率也能证出来。也有例外,比如纳维-斯托克斯这个千禧年难题,模型也给出了证明。
两三个月前我还是这么判断:只要一个问题对某个人来说是简单题,AI就一定能搞定。现在标准变了:只要一个人花足够功夫有机会解出来,AI大概率就能完成。但这类工作,只占我们数学研究很小一部分。我们确实会用“能不能证明定理”作为衡量标准,但这个标准只是一个替代指标。
我们真正想做的,是理解某种现象;如果连基础问题都没法证明,说明我们理解得还不够透彻。但不是所有开放猜想、定理都适合用这个标准衡量。实际上,我大部分工作,根本不是盯着一个写好的命题死磕证明。
更常见的是:我还在摸索这个命题本身应该是什么样。我前面也提到过,我常常是同时得到命题陈述和证明思路。对领域内专家来说,最后这个证明本身难度不算高,难点在于找到这个有价值的命题。
很多时候,我是一边得到答案,一边提出问题。有时候是偶然发现一种新技巧,试着寻找它还能适用在哪些场景;有时候是面对一个没有完全严格定义的研究对象,产生新理解,顺着理解提炼出可以证明的结论。
当然不是所有数学家都这么工作。确实有一部分研究者,和AI实验室的目标一致,专门寻找开放难题去攻克。但这不是我的工作方式,也不是大多数数学家的常态。不过我也不想贬低这件事,能攻克难题本身意义重大。
主持人:最近有一封公开信,不少菲尔兹奖得主和顶尖数学家联名,语气不算危言耸听,但确实敲响警钟,担忧AI和数学领域的相互影响。你能概括一下他们的核心顾虑吗?放任等于自毙,又一场数学家签名25位菲尔兹奖牵头1400多人签名声讨“AI人工智能在数学领域的严重错位”
丹尼尔:先说一句,我没有在这封信上签名。
我认可里面很多观点,但不完全赞同。按我的理解,这封信的核心观点是:AI公司把数学难题当成性能评测基准,这件事和数学行业原本的社群运行规则产生了冲突。
举个例子:一个知名开放难题,往往是一群研究者长期深耕的方向。在攻克它的路上,社群会衍生出大量新思路,有些思路不一定能直接解决原题,但能推动别的方向、沉淀研究者的能力,之后大家还能继续沿着这些思路产出更多成果。
AI相当于一条捷径,直接跳过了这个漫长过程,我们错过了沿途大量精彩的思路、衍生发现。很多附带的、偶然性的学术进展就此消失了。
主持人:所以他们认为千禧年这类难题不只是终点,它承载着带动整个领域发展的更高价值;AI直接拿下它,就夺走了这些成长机会?
丹尼尔:这话有一定道理。
千禧年问题确实起到了引导研究方向的作用,但它们本身的选定带有一定主观性。代数几何里,霍奇猜想、塔特猜想、奥古斯猜想,价值分量其实差不多,偏偏只有霍奇猜想入选千禧年大奖难题。
设想一个场景:所有人都扎堆研究霍奇猜想,其他同等重要的问题无人问津,这肯定不是好事。我甚至觉得,千禧年奖项本身就有问题,早在AI出现之前,它就已经在扭曲学科的发展导向,未必贴合人类知识探索的真正目标。
所以我认可这封信里的担忧,但没法完全认同。在我看来,核心矛盾不是AI本身带来的,而是我们旧有的学术体系需要适应新技术。如果一个重大猜想被AI证明,连带损失了很多衍生研究机会,问题根源在我们自己:我们完全可以继续去研究那些衍生的有趣问题,不是吗?
主持人:那说说你自己的立场。你怎么看待这件事?
丹尼尔:我很乐意聊聊我的看法。
首先,重大开放猜想,只是“人类理解”这个核心目标的一个并不完美的替代指标。我们想探索更深层的基础概念,而千禧年问题的选取很主观,用来衡量这个目标效果很差。
但与此同时,我们确实想要知道问题的答案,数学不是游戏、不是竞赛。我认为数学研究是人类最重要的探索之一。我真心想知道我研究问题的答案,我不在乎这个答案来自哪里。如果AI可以帮我得到答案,这是一件很棒的事。
主持人:这和很多人的观点好像冲突。很多人说:就算拿到答案,如果看不懂每一步推导,知道答案又有什么意义?
丹尼尔:我不觉得矛盾。
知道答案不是终点,恰恰是起点。不管是AI给出纳维-斯托克斯的证明,还是别的研究者证明了一个重大猜想,当我们知道“存在一份证明”之后,工作才刚刚开始。接下来你要去读懂这份证明。不管作者是人类还是AI,过程是一样的。
比如纳维-斯托克斯那份证明,是一份160页、写得非常晦涩的文档;换作别的数学家写的证明,也可能晦涩难懂。常规做法是先搁置原文,自己重新推导一遍。原文只能给你一些线索,你梳理出核心思路之后,往往会得到一套不一样的论证,中途冒出一大堆全新问题,再继续研究。
阅读文献里已有的证明,这件事本身和前沿研究几乎没有区别。研究很大一部分工作,就是用自己的方式去理解前人的成果。当然,你知道了这条路是可行的,不会再死胡同里盲目试错,但你依然会走入别的弯路,探索不会停止。
举个例子,千禧年问题里纳维-斯托克斯有四种表述,现在我们只拿到其中一种的结论,另外三种呢?
还有我认为第一个由AI独立做出的有价值成果:埃尔德什单位距离问题。我们想要得到一个下界,模型把下界小幅优化了,比如从n^1.001调到n^1.01,而上界还是n^(4/3)。它只是往真相挪了极小一步,距离彻底解决还很远。拿到这个结果之后,我们还是要继续寻找真正的精确结论。
在我看来,任何一份新证明的出现,永远只是一个起点,它几乎一定会引出无穷多新问题。文献里新增一份证明,本身从来不是坏事。它只是会和我们现有的学术规则、评价体系产生摩擦。这意味着我们要改造这套体系,这个过程会很艰难,短期内会有动荡。
我理解行业里很多人,尤其是年轻学者的焦虑,这种担忧非常合理。但同时,这也是一个绝佳机会,让我们的评价体系回归到追寻真理这个本源目标上。
主持人:会不会有一天,AI把研究前沿推到一个我们跟不上的地步?你坐在讨论桌前,AI抛出结论、完成证明,你发现自己完全跟不上它的抽象能力、推理高度,无力追赶?有没有被这种智能甩在身后的风险?
丹尼尔:布雷迪,你说和数学家聊天时经常觉得力不从心,其实所有数学家都有这种感受。我和同事讨论问题的时候,双方常常都觉得自己理解不了当下的内容。
做数学,很大一部分就是在这种“跟不上”的感觉里坚持下去。以我的经验,最后大多都能理顺。我不敢保证永远如此,但我保持乐观:我们总能学到东西,永远有可以研究的问题。
主持人:这就像人和汽车赛跑。汽车永远比人快,无论我怎么训练、多努力,都永远跑不过它。
丹尼尔:这个类比不太合适。
我们的目标不是追上、读懂AI产出的所有文本。过去几十年,数学文献总量早就超过了任何一个人能读完的上限。但一代代人依然可以走到前沿、做出贡献。
我们靠分工、靠不同专长的人互相协作,这是我们深耕领域的方式。AI工具反而能帮我们更快学习,更靠近前沿,发展出新的理解方式。
我预料未来几年,AI产出的数学文本总量,会超过人类历史上全部数学文献总和。必然会有大量内容永远没人细读。但核心问题是:我们能不能继续回答我们关心的基础问题?
我认为答案是肯定的。看现在AI产出的数学内容,其实带着很强的人类特质。OpenAI放出过单位距离问题的思维链记录,读起来就像一名优秀数学家把自己思考过程写下来。我相信我们会从中收获巨大,整体会变得更强。我不认同把这件事看作我们和AI的竞赛。
主持人:你最近在博客写了一篇相关文章数学家心声:Daniel Litt丹尼尔·利特《数学的一个新开端》2026-9-14。简单概括一下,你想传递的核心观点是什么?
丹尼尔:首先,这是一个激动人心的时代。
大家的担忧合理:研究生、博士后会担心,未来求职的时候,评价标准变成“用AI一键批量生成证明”,大家不再追求深度理解;这套激励机制会扭曲数学研究,让研究者失去研究的乐趣。如果我们什么都不做,这个局面确实会发生。我们前面聊过很多次,原有的学术激励体系,正在被新技术冲击。
我文章的第二部分,就是提出行业可以落地的办法,保护人类研究能力,鼓励深度理解,而不是单纯点一下按钮生成证明。文章发布之后,我和很多同行交流,发现这些想法几乎已经成为圈内共识。
我预计下一轮招聘季就会看到变化:评审研究生、博士后求职材料的时候,不会再单纯看产出了多少论文文本——论文数量已经不再是理解能力的可靠指标。评审会重点考察这个人是不是真的热爱数学、有没有真正学到东西,而不是只会调用AI生成证明。这是非常积极的信号。
总而言之,如果你热爱数学、想要钻研数学,当下是一个很棒的时代。我想说明:现有的激励体系急需快速调整。很多同行也自发得出了相同结论。文章收到的反馈很鼓舞我,很多人跟我说,道理本来就显而易见,我们可以一起解决AI暴露出来的这些问题。
主持人:你觉得AI,以及未来更先进的AI,会让你成为更好的数学家吗?
丹尼尔:肯定会。
当然挑战也很多,比如预印本平台arXiv投稿量暴涨,很难筛选出真正有价值的工作。AI写出来的文稿质量参差不齐,也就是大家说的“数学垃圾文稿”。哪怕里面藏着重要结论,行文也经常写得很差。这类难题还有不少,但我相信未来几年我们依然能做出很棒的成果。
主持人:你会不会担心它变成拐杖?现在很多人遇到问题直接问AI,不再自己检索、独立思考,慢慢丧失探究能力。你会不会也有这个顾虑?比如本来可以自己一步步推导出这几条引理,现在直接交给AI完成?
丹尼尔:这确实是风险。
把一项思考工作交给AI,你就失去了练习这项能力的机会。如果一名研究数学家长期这么做,肯定不是好事,选择权在我们自己手上。我拿到AI给出的有用结论之后,会关掉电脑,花一周时间独立复盘推导。
我们必须主动建立方法,避免这种能力退化。对于刚入行的本科生、研究生,这点尤其关键。我会和学生沟通,鼓励他们用AI,但要用对方式。
我觉得有很简单的机制可以抵御这种能力退化、保证研究者功底扎实:授予博士学位,不能只看论文,要有严格的答辩,要求学生把论文里所有内容讲清楚,直到评审满意;学者做学术报告,会被不断提问。
如果一个人连自己成果的内核都讲不明白,会非常难堪。这些本来就是我们该坚持的流程。我认为数学的核心是人的理解,所以我们必须保证研究者可以独立阐释自己的工作。所以我没有那么担心。滥用AI的后果会非常明显,很容易识别,大家自然会避开这种错误用法。
主持人:AI在数学领域的讨论两极分化,有人支持有人反对。你发表观点之后,除了正面反馈,会不会收到批评、反对的声音?
丹尼尔:当然会,这个话题本身争议极强。
我一直认为,不是所有人都必须使用AI,行业里也容得下完全不碰AI的研究者。甚至有坚决不用AI的同行,也给过我正向反馈。
但很多人是焦虑的:担心工作岗位、担心研究不再有趣。还有人对数学本身的意义有不一样的理解。我的看法是数学是一门科学,拿到答案本身就有价值;但有些人入行,本身就是享受解题这个过程本身。AI擅长解题之后,这份乐趣的价值会被弱化,他们有理由感到失落。
这些分歧都非常合理。我们现在正在讨论的,本质上是:我们做数学到底是为了什么?大家的答案并不统一。
主持人:你说大家入行的初衷不一样,能不能讲清楚?你的初衷是什么?另一种更抵触AI的初衷是什么?
丹尼尔:我认为数学是科学。
我们在追问关于世界、宇宙最底层的问题,比如“什么是形状?”“什么是数?”。我们想要找到答案,同时理解答案背后的内涵。理解是一个过程,但我们同样看重最终的结论。
另一类同行,把数学看作艺术,更偏向人文学科。对他们来说,攻克难题这件事本身就自带价值,有点像写诗。有人形容,研究数学可以完善自我、造福社会。我觉得这个看法也有道理,它和新技术本身并不冲突,只是AI冲击了适配这套理念的旧激励体系。
还有一部分人认为:有些问题甚至不该被解开,因为研究它的过程本身就有内在价值。这是我们根本的分歧。而且这个分歧早在AI诞生之前就存在,无关AI。
我觉得行业里可以容纳所有这些视角。当然,如果有人不认同我底层的出发点,自然不会认同我的观点。但整体来看,哪怕有分歧,大家的讨论都还算理性。
让我很欣慰的是:我们的分歧大多来自哲学层面——我们怎么理解数学的意义。但落到实操层面,大家共识很多。哪怕你认为数学是人文学科,只要你同样重视保护人类研究能力、保证二十年后还有优秀的数学家,我们就可以共存。
主持人:持这种“数学如诗”观点的学者,有没有做出过划时代的重大突破?
丹尼尔:当然有,很多顶尖数学家都持有这种想法。
不是说他们不会证明定理、不会做出重大发现。区别只是驱动你的动机不同。说实话,不管是把数学当成科学,还是当成诗歌、一套自洽的体系,做数学都很难,每个人都需要给自己一个精神叙事来支撑自己坚持下去。这些自我叙事,未必和整个学科的宏观目标完全一致。我个人觉得“数学是科学”这个叙事,更贴合学科整体的方向,但行业里完全可以容纳不同的精神寄托。
主持人:非常感谢丹尼尔·利特抽出时间。下方有相关链接,包括我们提到的那篇博文。我是布雷迪·哈兰,这里是Numberphile播客。本期节目得到简街资本、Patron支持者,以及最重要的各位听众的支持。谢谢大家。
参考资料
https://www.youtube.com/watch?v=UTvwV9oPgxk
一个新生代数学家论坛网站foruma.org
陶哲轩:从数学1.0迈向数学2.0——科学×AI峰会报告全文2026-10-16
AI数学百家争鸣:《百份解,百种回响》Proofs and Prompts 2026-10-8
专访丹尼尔·利特(Daniel Litt):数学家还剩下什么?——信息瓶颈播客2026-10-20
数学家心声:Daniel Litt丹尼尔·利特《数学的一个新开端》2026-9-14
数学家丹尼尔・利特(Daniel Litt)创建的数学未解难题网站正式上线——ProblemsILike.com
巴别图书馆中的数学——多伦多大学数学家丹尼尔・利特(Daniel Litt)再谈AI人工智能与数学研究的未来
专访数学家Daniel Litt(丹尼尔・利特):AI人工智能的数学能力或长期处于不均衡发展状态(上)
专访数学家Daniel Litt(丹尼尔・利特):AI人工智能的数学能力或长期处于不均衡发展状态(下)
原标题:《《学会与AI共存》对话数学家丹尼尔·利特(Daniel Litt)——Numberphile播客by 布雷迪·哈兰(Brady Haran)》
本文为澎湃号作者或机构在澎湃新闻上传并发布,仅代表该作者或机构观点,不代表澎湃新闻的观点或立场,澎湃新闻仅提供信息发布平台。申请澎湃号请用电脑访问http://renzheng.thepaper.cn。

- 报料热线: 021-962866
- 报料邮箱: news@thepaper.cn
互联网新闻信息服务许可证:31120170006
增值电信业务经营许可证:沪B2-2017116
© 2014-2026 上海东方报业有限公司