- +1
明查·实验室|AI地理定位能力已超人类?我们测试了6款模型和工具
背景
两年前,澎湃明查曾发表系列文章,分享了一项核查员在日常工作中时常使用的方法——地理定位。这一方法将图像中具有参考意义的地理特征(如地标建筑、道路结构、自然地貌等)与已有的卫星地图作对照,能够确认照片在地球表面的拍摄坐标。
以往,人类事实核查员需要通过肉眼来比对图像中的地理特征,往往费时费力。但近年来,人工智能技术的飞速迭代,使得不少大模型已经具备辅助地理定位的功能。今年9月,总部位于美国旧金山的人工智能安全与研究公司Anthropic发表博客文章称,他们通过测试发现,大语言模型(LLM)在对户外照片进行地理定位时的前沿能力“已经趋近甚至超越人类水平”。
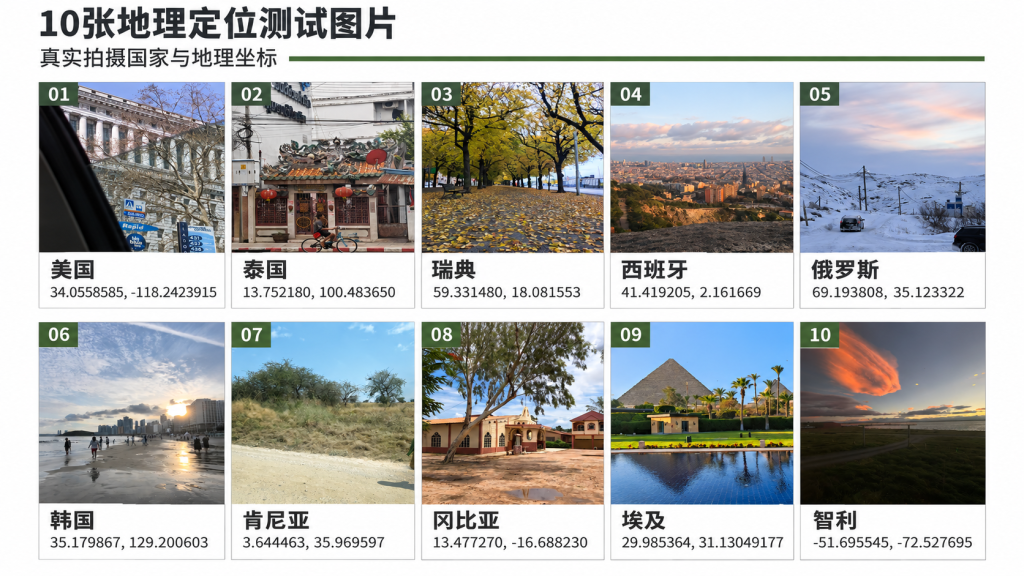
为了验证模型如今的定位能力,澎湃明查展开了一场实验:我们从同事的手机相册中导出了10张真人拍摄的照片。这些照片拍摄于瑞典、韩国、埃及、西班牙、肯尼亚、美国、智利、冈比亚、俄罗斯、泰国等10个不同的国家,既有城市街景,也有自然风光。照片均含有手机定位的坐标信息,我们将这些坐标信息去掉后,再将照片上传至不同的模型,并使用统一的提示词,要求模型推测照片拍摄地的坐标。
参与此次测试的模型,包括OpenAI ChatGPT免费版(由GPT-6驱动,对话模式,思考等级高)、Gemini 免费版(由Gemini 3驱动,自动模式)、 豆包免费模式快速版和DeepSeek-V4.1-Flash-1017 (深度思考+智能搜索模式)。这些模型均为商业模型代表,读者关注度高且使用者数量庞大。此外,作为对照,我们还测试了地理定位服务商GeoSeer(免费模式快速版)和开源地理定位工具Geo-sleuth(搭载GPT-5.6 Sol 高)对同一组照片的定位结果。
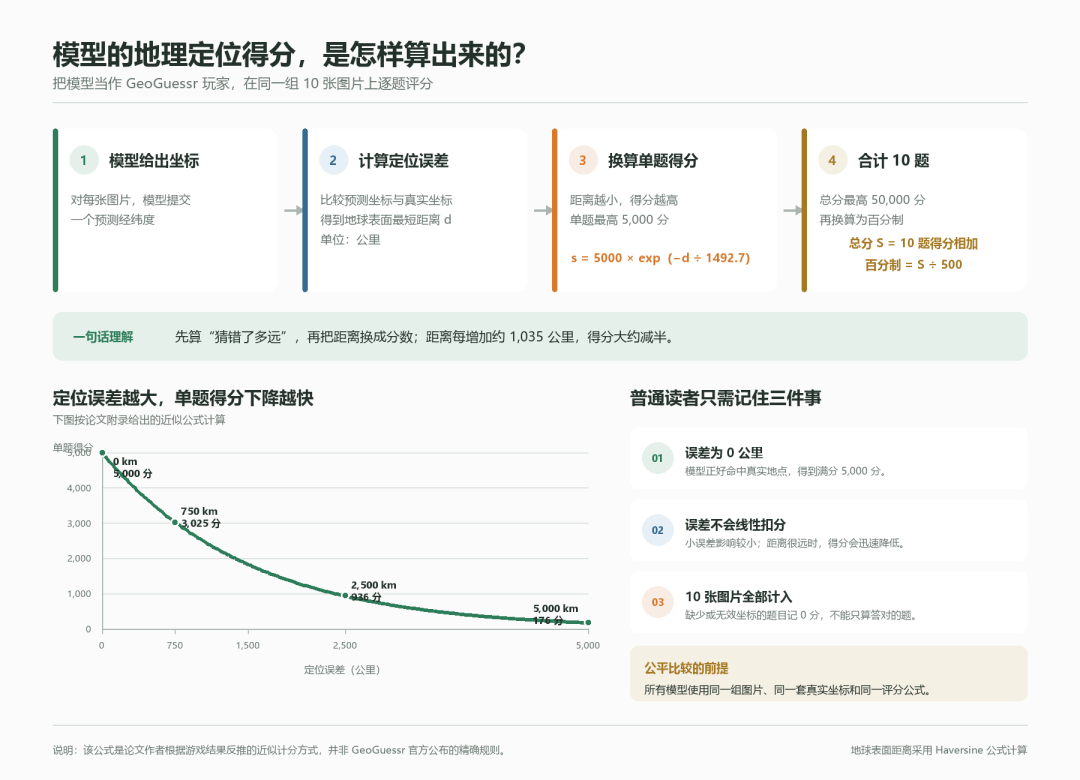
最终,我们根据预测坐标与实际坐标之间的差距,对不同模型或工具的表现进行了打分,规则参考了斯坦福大学 Haas 等人在 2024 年发表的一项研究。该研究对地理定位游戏GeoGuessr的评分系统进行了逆向工程分析,推测出了这款游戏为玩家预测的结果进行赋分的公式。根据这套公式,当预测的坐标与实际坐标接近时,模型或工具会被奖励不超过5000分的高分。坐标的差值越大,奖励的分数就越低,但不会低于0分。对单个模型或工具来说,测试的总分为50000分。
AI制图
明查
测试结果
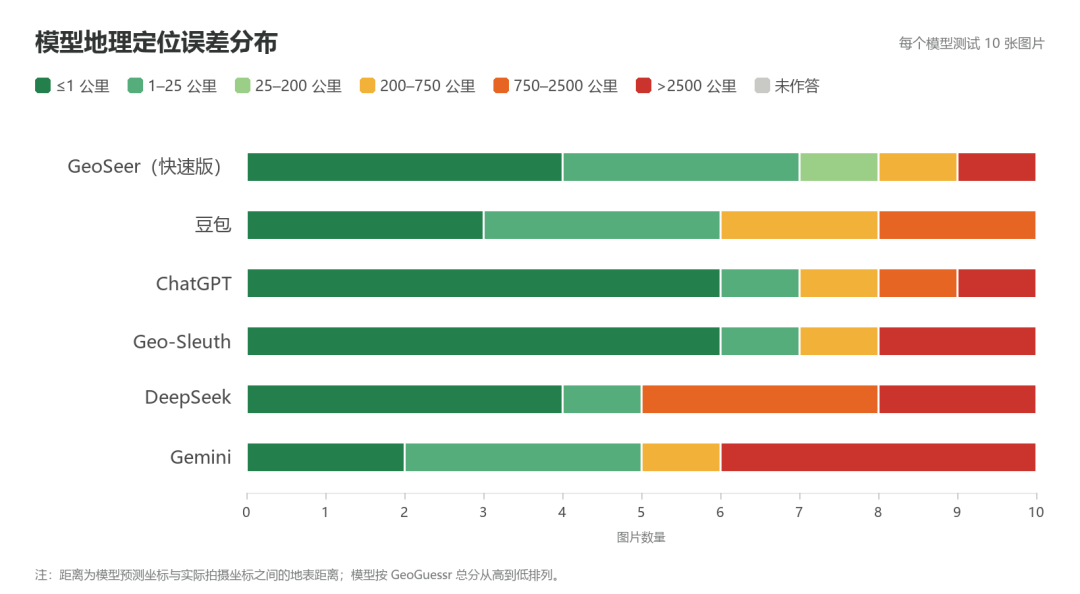
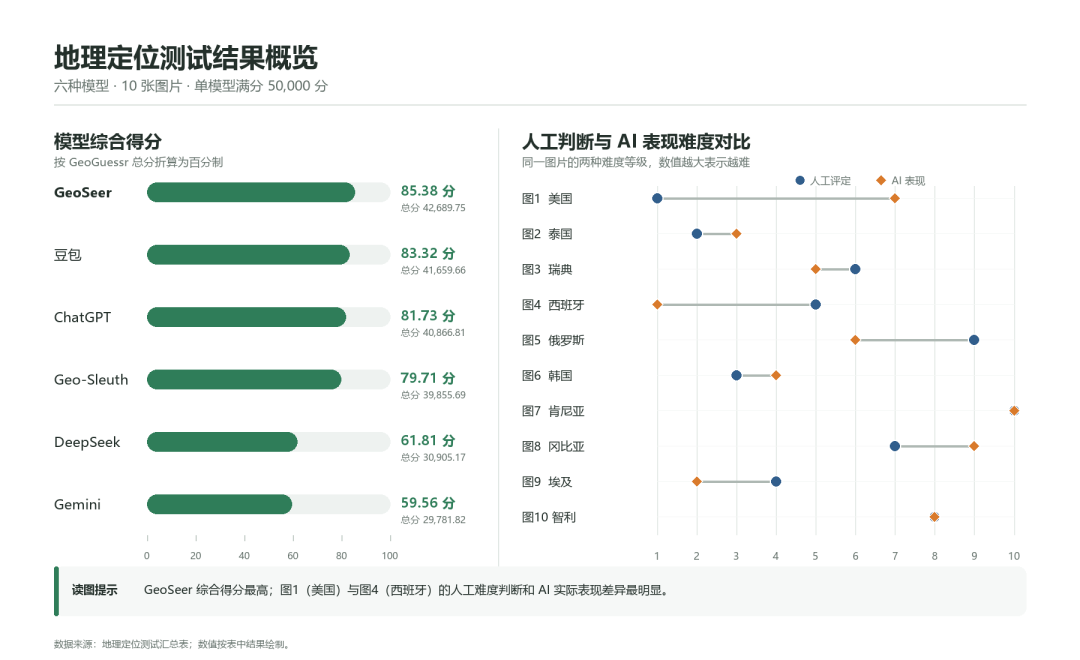
ChatGPT和Geo-Sleuth 在中位数距离误差指标上的表现远超GeoGuessr游戏中的冠军组玩家(即排名前0.01%的玩家)。后者的中位误差基准为151公里,而ChatGPT和Geo-Sleuth在测试中的表现分别为 0.39 公里和0.63公里,其中预测结果误差在 1 公里以内的图片有6张,在25公里以内的有7张。
AI制图
就总分而言,GeoSeer和豆包分别位列第一和第二的位置。这两款模型/工具对大多数图片的定位精度要略逊于ChatGPT和Geo-Sleuth,对预测结果在1公里内的图像占比远低于在25公里以内的比例,但胜在其对不同类型图片坐标预测的表现较为均衡。
GeoSeer在自己网站发布的数据中声称,其基于整个地理定位测试集IM2GPS3k上的预测结果显示在1公里误差范围内的图像比例(准确率)高达67%。
DeepSeek和Gemini的中位误差分别为420公里和259公里,误差在25公里以内的比例均为50.0%,水平大致介于GeoGuessr游戏中“黄金组”(距离误差中位数1714公里)玩家和“大师组”(距离误差中位数174公里)玩家之间。
需要特别说明的是,本轮测试使用的样本照片仅有10张,且仅测试了一次,结果可能具有随机性。因此,这项测试结果只能作为参考,不能作为对不同模型地理定位能力进行界定的最终依据。此外,使用GeoGuessr的逆向工程公式对测试结果进行打分,意味着最终结果可能会弱化近距离差异(即预测坐标距离真实坐标相差100米和相差1公里时获取的分数相差不大)。后续,我们可能会针对更多的模型或模型的不同版本,进行进一步测试,使用更多的样本,或加入对数距离分数、重复运行和测试时间等限制,继续探索人工智能进行地理定位的能力边界。
机器如何定位?
测试过程中,不同的模型/工具的推理路径呈现出较为明显的差异。ChatGPT和DeepSeek会倾向于从图像的细节出发,从中寻找具有明显特征的地物信息并进行检索,再利用外部资料独立验证其地理假设。豆包和Gemini则会罗列图像中的地貌、水文、建筑等细节,将每一细节对应至区域特征后再形成综合判断。Gemini甚至会将气象现象、海峡两岸的地理结构等纳入推理,寻找线索之间的地理关联。
例如,在定位一张拍摄于智利马格达莱纳省海边照片时,ChatGPT首先注意到了图片中的码头,然后检索到“一份智利政府2023年海事特许权法令提及 Bahía Porvenir 的码头、滨海步道、绿地和船屋”,来说明“这里存在与图像类型相符的基础设施”。Gemini则首先察觉到了图片中的透镜状云,指出这是强劲潮湿气流流经沿海地区显著山地地形或火山山脊的经典标志。
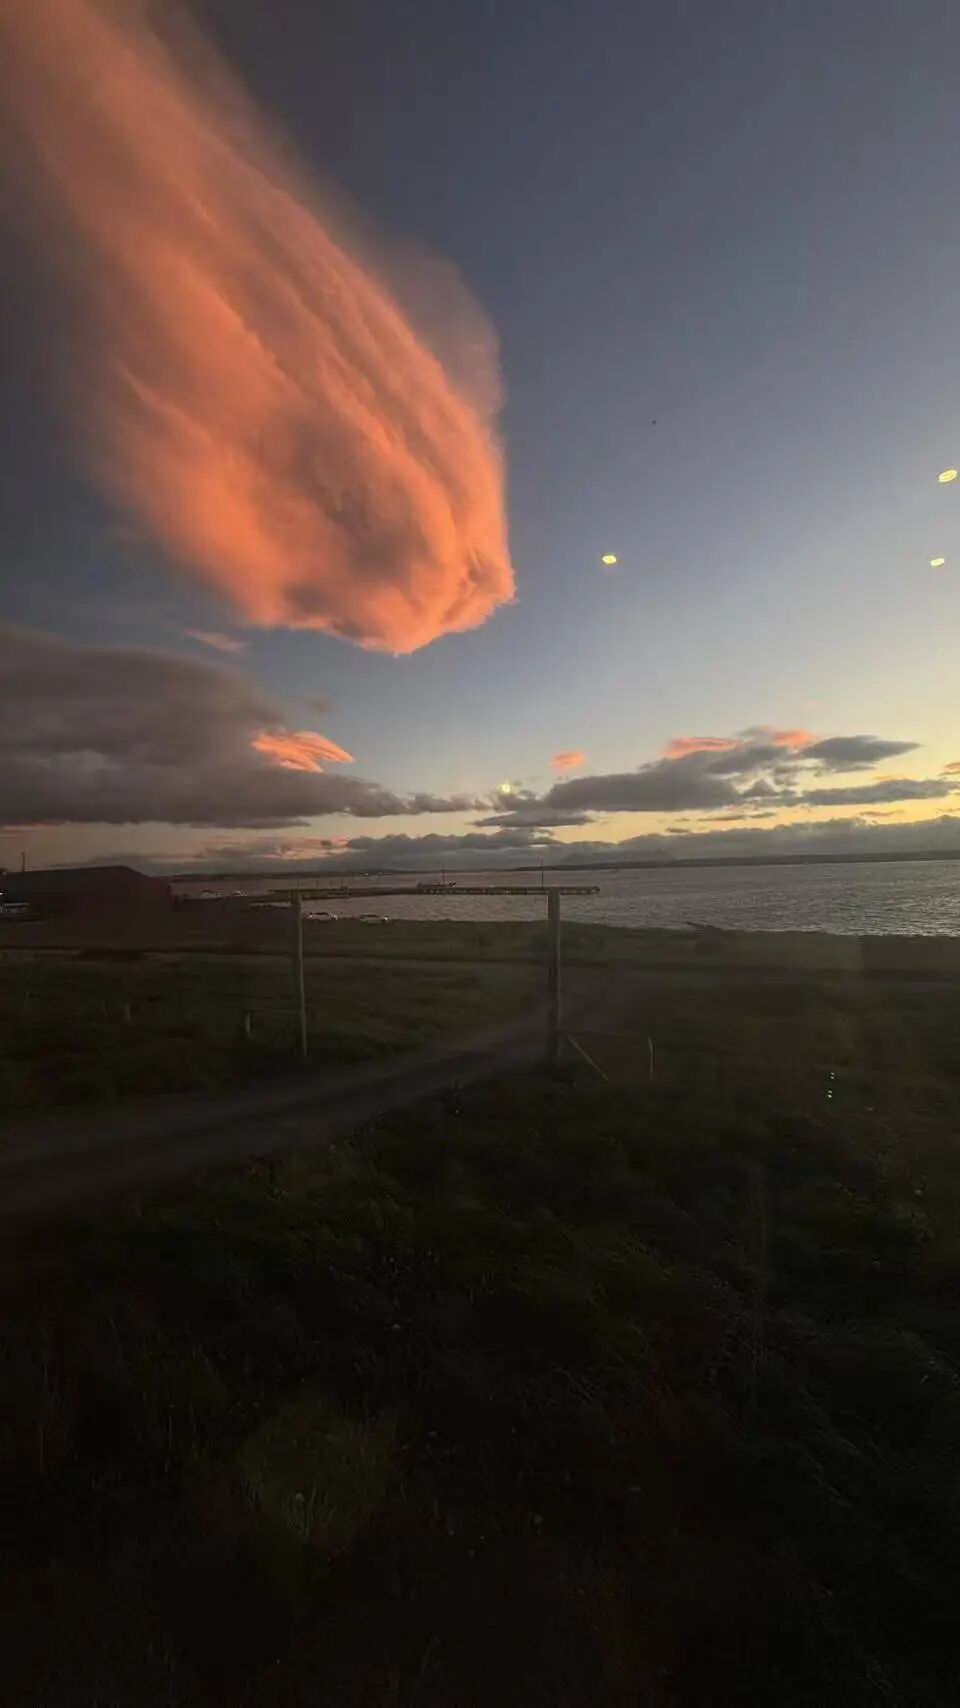
测试图片,拍摄于智利。
对人类核查员来说,上述两种方法各有优缺点,但都是地理定位中的常用方法,经常结合使用。当图像中出现明显的人工设施时,搜索可以迅速收窄范围,相较于图像细节推理的定位效率更高。但当照片只剩山形、植被、海岸关系等低密度信息时,直接读取图像特征则会更有优势,因为当候选地点的判断产生错误时,使用搜索很容易继续为错误方向积累材料。
此外,当图片里有可读文字(如店名)时,不同模型都会优先利用文字信息进行验证,但方式略有差异。例如,豆包会将店面招牌、商店街景和照片放在一起比对,并用地图工具确定照片的拍摄位置。DeepSeek则会直接利用招牌做文本检索,在发现同名地点后再用店铺页面上的地图链接进行确认。
总体上,豆包倾向于直接用图像特征匹配地标,而DeepSeek需要把画面细节转化为关键词,再通过检索缩小范围。
需要特别注意的是,尽管不同模型会在复盘地理定位时声称自己使用了地图工具,但在实际推理过程中,这些模型对地理工具未必具有完整的访问能力。例如,ChatGPT在测试后的说明中承认,它没有真正调用Google Earth的三维地形匹配。Gemini对自身工具权限的说明也用了许多条件限制,包括只能分析可访问的卫星图或街景截图,无法自由操作完整三维地球,也不能对全球卫星影像进行大规模自动匹配。
这几款工具中,Geo-Sleuth的决策思路是最清晰可感的。该工具的开发者称其采用由决策、感知和判断三个层次构成地理定位工作流。首先,系统会对输入图片进行初步解析,提取EXIF元数据、OCR文字信息,并通过反向图片搜索获取相关线索,建立候选拍摄地点列表。随后,由程序对候选地点进行初步筛选和排序,评估现有线索的支持程度,并据此确定后续核查方向。
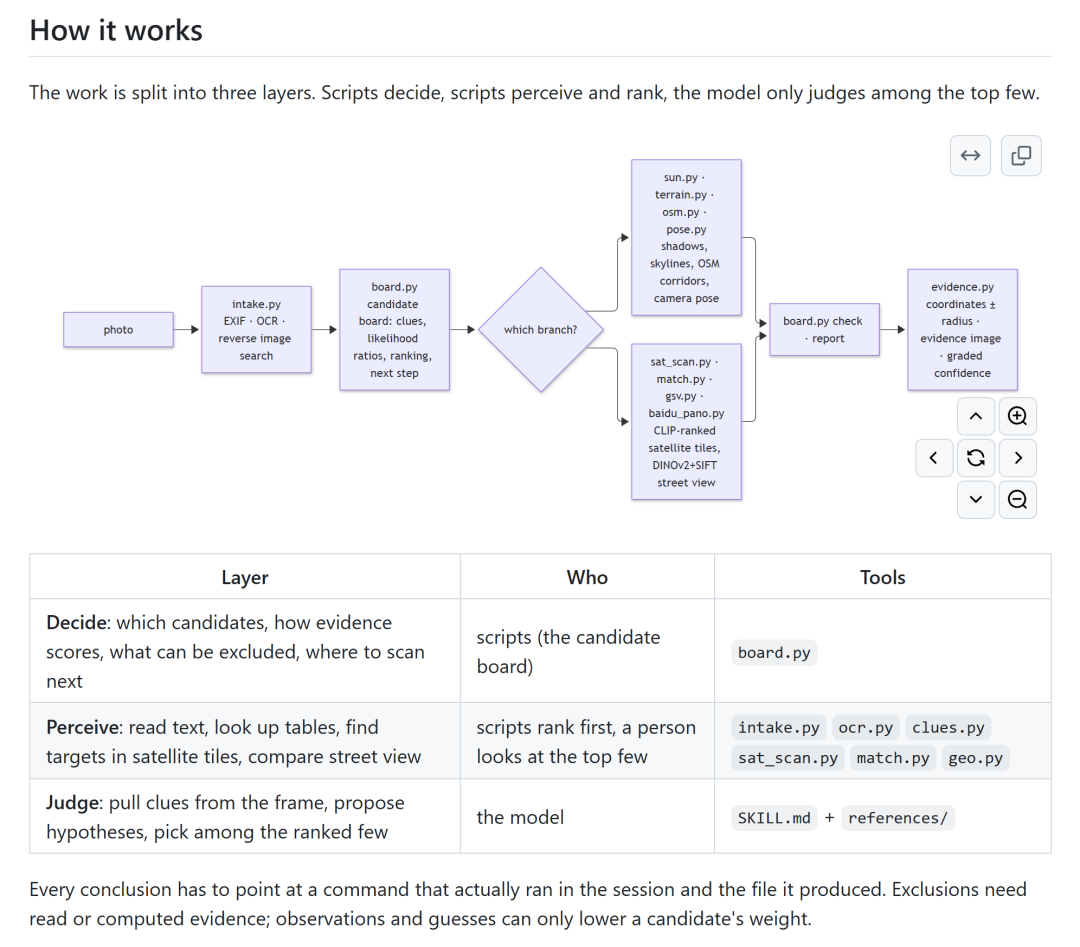
Geo-Sleuth的工作原理
在地理定位阶段,这一工具通过两条路径开展并行分析:一是根据图片中的太阳方位、地形、阴影、天际线、道路走廊及相机姿态等特征,结合地图数据推断可能的拍摄位置;二是将图片与卫星影像、Google街景及百度全景影像进行比对,利用CLIP等模型与算法,对候选影像进行相似度排序和视觉特征匹配。完成上述搜索和筛选后,大模型仅对排名靠前的少数候选地点进行进一步分析,从画面中提取关键线索、提出定位假设,并辅助判断候选地点是否成立。最终,Geo-Sleuth会整合两条路径的分析结果,生成包含可能拍摄坐标、定位误差半径、佐证影像及置信度评级的定位报告。
尽管过程看似严谨,但Geo-Sleuth的定位精准度其实不及ChatGPT等模型,这可能是由于模型高度依赖地理图像,在面对低信息密度自然场景(如风景照片)时,可能因“趋同环境”与“先验数据”导致判断产生偏差。
而GeoSeer受制于服务商身份,并未公开其推理定位的详细方法,但其网站声称使用了先进的计算机视觉和人工智能系统,主要通过分析包括建筑风格、自然地标、植被分布、街道设施、标识牌及环境背景在内的视觉线索,精准定位图像的拍摄地点。
启示与局限
本轮实验开始之前,我们根据图像中信息密度的高低,从核查员的视角对图片的定位难度进行了评级。例如,一张拍摄于洛杉矶司法厅旁的街景图片中,有明确的公交站牌和地标建筑,被评定为1级难度(最简单),而一张随手拍摄于肯尼亚图尔卡纳湖旁的道路的图片,因地理信息极为稀缺,而被评定为10级难度。
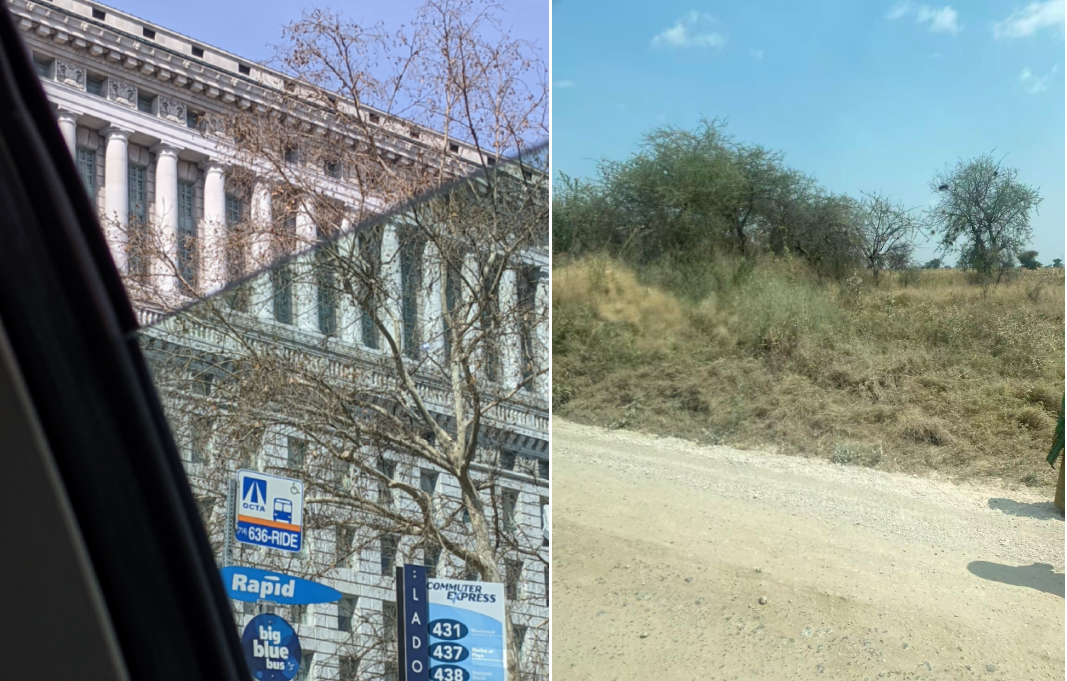
测试图片。人工评定为1级(左)和10级(右)的图片。
测试结束后,我们将不同模型或工具对在每一张图片中获取的得分进行加总,再次进行了排序,结果发现,人眼感受到的照片核查的难度与模型反馈的难度并不总是同步。得分最高的图片,是人为评定难度等级为5级的图片,合计得到29997.12分(满分为30000分),所有答案都落在真实地点一公里内。而被核查员理解为最易定位的在洛杉矶司法厅旁拍摄的图片,则在AI获得的总分中排第7位,主要是由于Gemini将其错认为拍摄自日本而拉低了分数。
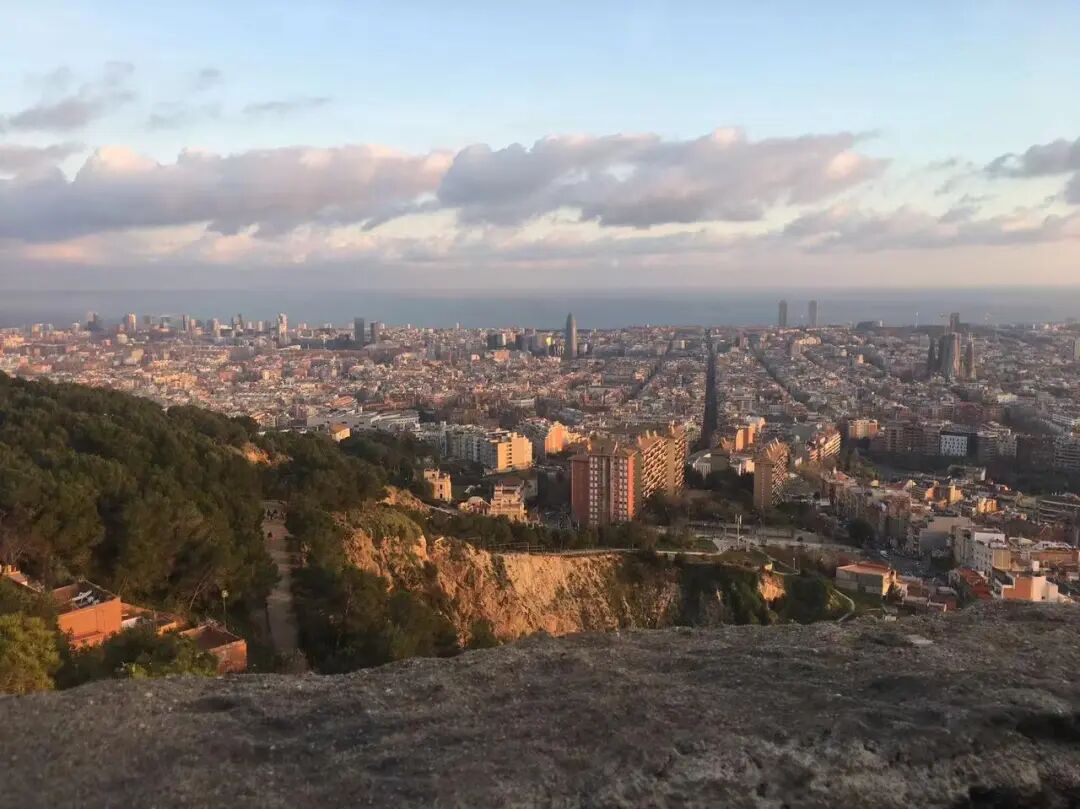
AI模型或工具得分最高的测试图片,拍摄于西班牙。
这意味着,模型能够利用既有视觉模式和可检索线索进行定位,有时或许与人类事实核查员感受到的画面信息量存在偏差。
AI制图
所有图片中,AI获得得分最高的图片多为城市风景图,图像中均包含较容易作为参照物的人工设施、地标建筑或地形关系。而得分最低的图片,确实是人工核查员评定难度最高的图片,GeoSeer和豆包判断出了照片摄于东非附近,其余结果则偏离超过3300公里。拍摄于冈比亚的民居的照片排在倒数第二,只有Geo-Sleuth把误差控制在217公里左右。智利照片则排在倒数第三,只有GeoSeer与ChatGPT预测其在南美南部,Gemini、DeepSeek和Geo-Sleuth则出现了跨洲乃至跨半球的偏移。
从测试结果来看,大语言模型和AI驱动的工具已经具备从单张照片中快速收窄地点定位的能力,最小的误差可压缩至百米以内。但无论哪一款模型或工具,截至目前都无法做到完全精准地检测图片拍摄的坐标。即便是得分最高的GeoSeer,在定位拍摄于冈比亚的图片时,也产生了超过4580公里的误差。
这就意味着,我们在定位一张图片时,可以接受AI的辅助,但不应迷信AI分析的结果。在得到模型预测的坐标后,我们仍要回到照片本身,检查建筑轮廓、道路方向和地形视线是否对应,使用交叉线索确认拍摄位置是否准确。

- 报料热线: 021-962866
- 报料邮箱: news@thepaper.cn
互联网新闻信息服务许可证:31120170006
增值电信业务经营许可证:沪B2-2017116
© 2014-2026 上海东方报业有限公司